Năm
2026
Vai trò
Một mình — sản phẩm, backend, pipeline AI, frontend, triển khai
Công nghệ
- Python
- FastAPI
- PostgreSQL
- pgvector
- scikit-learn
- OpenAI API
- React
- TypeScript
- Cloud Run
- GitHub Actions
Công cụ nghiên cứu · Agentic RAG
ResearchMap AI
Biến một câu mô tả lĩnh vực nghiên cứu thành bản đồ tài liệu gồm chủ đề, xu hướng và khoảng trống. Một agent trả lời câu hỏi về lĩnh vực và chỉ trích dẫn những bài báo nó thực sự truy xuất được.
researchmap.ngwkhai.com
Không cần đăng ký: phiên khách chạy được một lượt phân tích trọn vẹn cho một lĩnh vực.
- Tự xây dựng toàn bộ sản phẩm: backend FastAPI trên PostgreSQL và pgvector, frontend React, đăng nhập Google OAuth với xác thực hai lớp TOTP, các gói dịch vụ có hạn mức, và trang quản trị.
- Thiết kế pipeline phân tích: LLM lên kế hoạch truy vấn OpenAlex, bài báo được nhúng rồi phân cụm bằng KMeans, LLM đặt tên từng chủ đề, còn khoảng trống nghiên cứu được tính từ những cặp chủ đề không có bài chung.
- Xây dựng chat agentic RAG bằng tool calling của OpenAI, gồm 7 công cụ và tối đa 4 vòng. Trích dẫn chỉ lấy từ những bài mà công cụ trả về, và có ngưỡng liên quan được đo trên dữ liệu thật.
- Đánh giá hệ thống bằng bốn bộ benchmark có LLM làm giám khảo, và triển khai lên Cloud Run bằng GitHub Actions với Workload Identity Federation.
- Bài trích dẫn được xác minh có thật
- 36/36
- Precision@5 của truy xuất
- 0.867
- Chi phí mỗi câu trả lời
- $0.00032
- gpt-5.4-nano, đo thực tế
Bài toán
Người mới bước vào một lĩnh vực nghiên cứu lạ cần biết bốn điều: lĩnh vực có những nhánh nào, nhánh nào đang phát triển, bài báo nào quan trọng, và chỗ nào còn trống. Công cụ tìm kiếm không trả lời được những câu này, còn chatbot đa dụng thì trả lời mà không có bằng chứng. Sản phẩm được làm trong chương trình AI20K Build Cohort 2.
Cách làm
- Lên kế hoạch tìm kiếm. LLM chuyển câu mô tả của người dùng thành ba đến tám truy vấn tiếng Anh cho OpenAlex. Kết quả được khử trùng lặp theo DOI, sau đó theo tiêu đề.
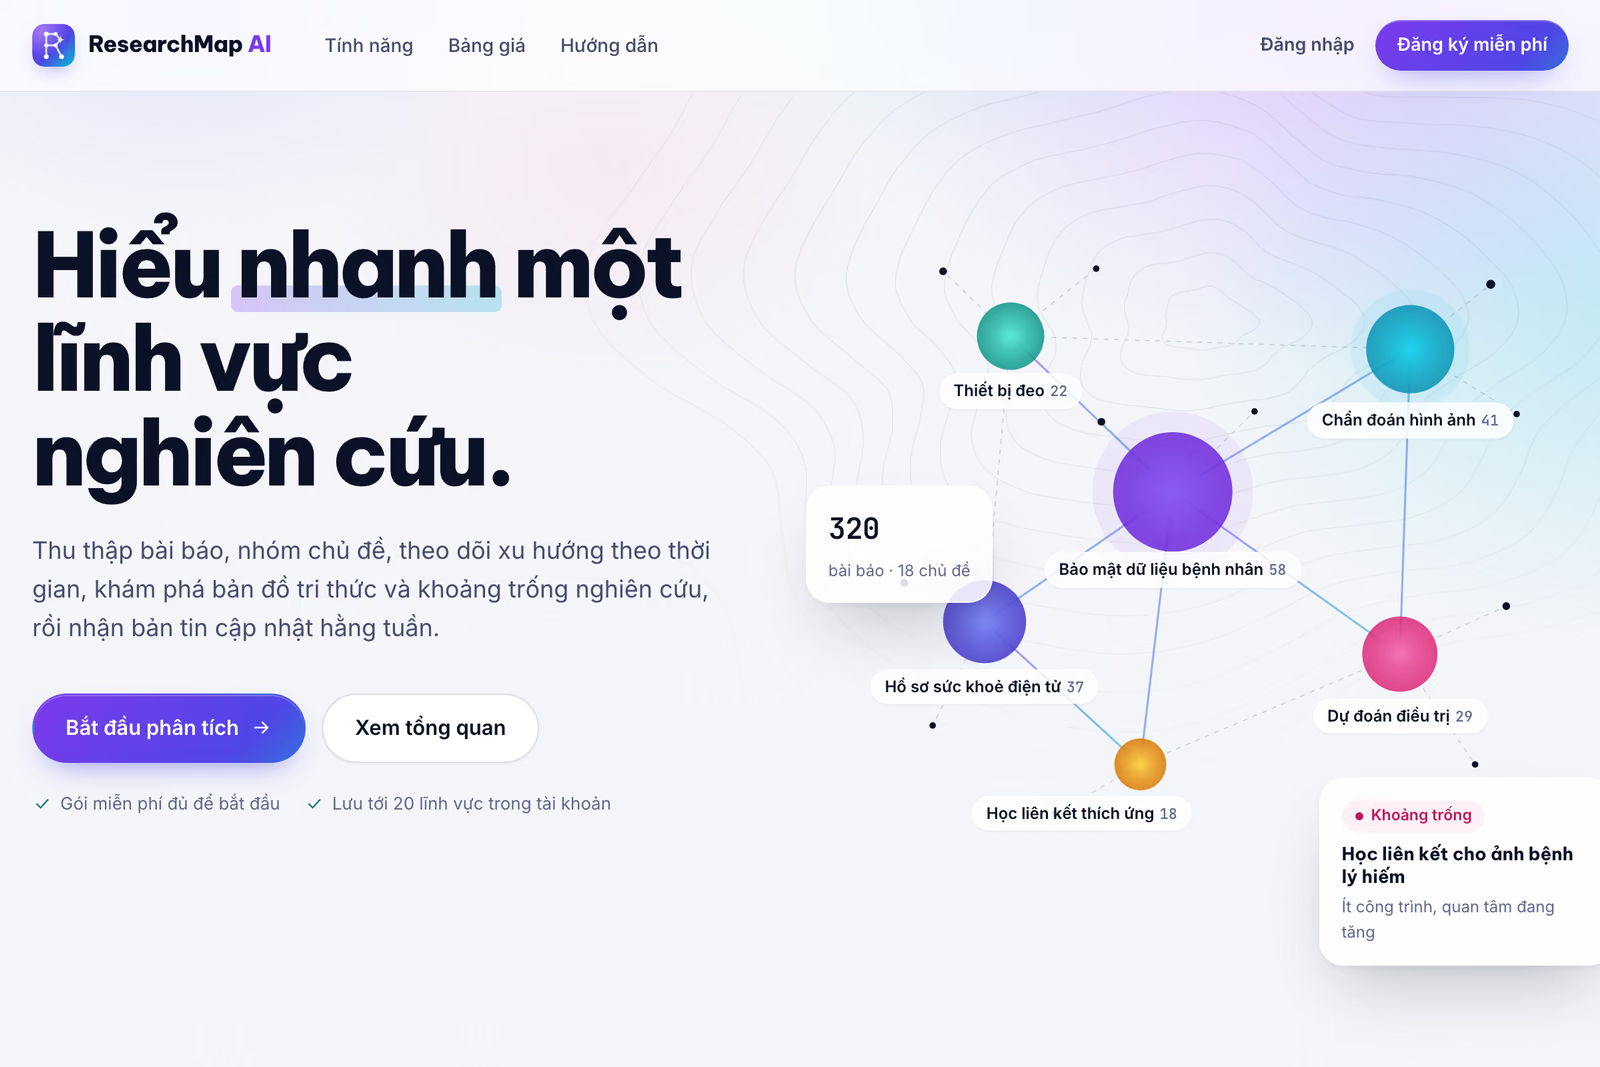
- Chủ đề. Bài báo được nhúng vào pgvector và phân cụm bằng KMeans, với số cụm chọn theo quy mô tập bài báo. Sau đó LLM đặt tên cho từng cụm. Tập demo 320 bài cho ra 18 chủ đề.
- Khoảng trống. Khoảng trống được tính toán chứ không phải do mô hình sinh ra. Mỗi cặp chủ đề không có bài chung được đề xuất là một khoảng trống, kèm theo các bài báo làm bằng chứng.
- Chat có căn cứ. Trích dẫn được gom từ kết quả của công cụ, không lấy từ phần chữ mô hình viết. Trên tập dữ liệu này, câu hỏi đúng chủ đề đạt độ tương đồng cosine 0,55–0,79, còn câu hỏi lạc đề chỉ đạt 0,15–0,31, nên ngưỡng 0,35 được đặt ở khoảng giữa. Nhờ vậy, câu hỏi lạc đề nhận câu trả lời "chưa có dữ liệu" thay vì bị bịa. Nội dung bài báo được rào lại như dữ liệu để chống prompt injection.
Kết quả
- Cả 36 bài được trích dẫn đều được xác minh là có thật trong database. Trợ lý phân loại đúng cả 15 câu hỏi thử là đúng chủ đề hay lạc đề. LLM giám khảo chấm trung bình 8,0/10.
- Precision@5 của truy xuất đạt 0,867. Precision của bước lập kế hoạch truy vấn đạt 0,886.
- Mỗi câu trả lời tốn $0.00032 với
gpt-5.4-nano. - Đặt tên chủ đề là phần yếu nhất, đạt 6,25/10. Báo cáo ghi rõ điều này thay vì giấu đi.
Triển khai
Một container trên Cloud Run phục vụ cả API lẫn frontend, dùng Cloud SQL và Secret Manager. Mỗi lần push lên main, GitHub Actions tự triển khai qua Workload Identity Federation, nên không cần lưu khoá service account nào.